KI · Geodaten
TypeSafe Jev: KI-Urteile in der Archäologie
Was ein System-One-Modell anders macht als ein LLM, wo Jev in der Archäologie geholfen hat und wo es gescheitert ist – mit echten Antworten und Messwerten.
Passende LeistungKI-Beratung & Umsetzung
12 Min. LesezeitOnur CirakogluAktualisiert
Inhalt · 10 Abschnitte
Seit einigen Wochen gibt es eine neue Art von KI-Modell, die kein Text schreibt. Man schickt ihr einen Zustand und typisierte Fragen, und sie antwortet mit Wahrscheinlichkeiten, die Code direkt verarbeiten kann. TypeSafe nennt das ein System-One-Modell, das erste heißt Jev. Wir haben es im September 2026 auf Aufgaben aus der Archäologie und Fernerkundung getestet, also genau dort, wo ein Sprachmodell sonst Text produziert, den man anschließend mühsam zurück in Daten verwandeln muss.
Dieser Artikel ist ein Erfahrungsbericht, kein Werbetext. Er erklärt, was Jev anders macht, zeigt, wo es im Test funktioniert hat, beim Sortieren eines Denkmalregisters, und wo es gescheitert ist: bei der Beurteilung von Kandidaten im Gelände. Beides mit den echten Fragen, Antworten und Messwerten.
Was ein System-One-Modell anders macht
Ein Sprachmodell wie GPT oder Claude erzeugt Text, Token für Token. Will man damit klassifizieren, schreibt man einen Prompt („Antworte nur mit einer der folgenden Kategorien …“), hofft auf Gehorsam und parst die Antwort. Die berühmte „Konfidenz“, die das Modell dabei nennt, ist erzählt, nicht gemessen.
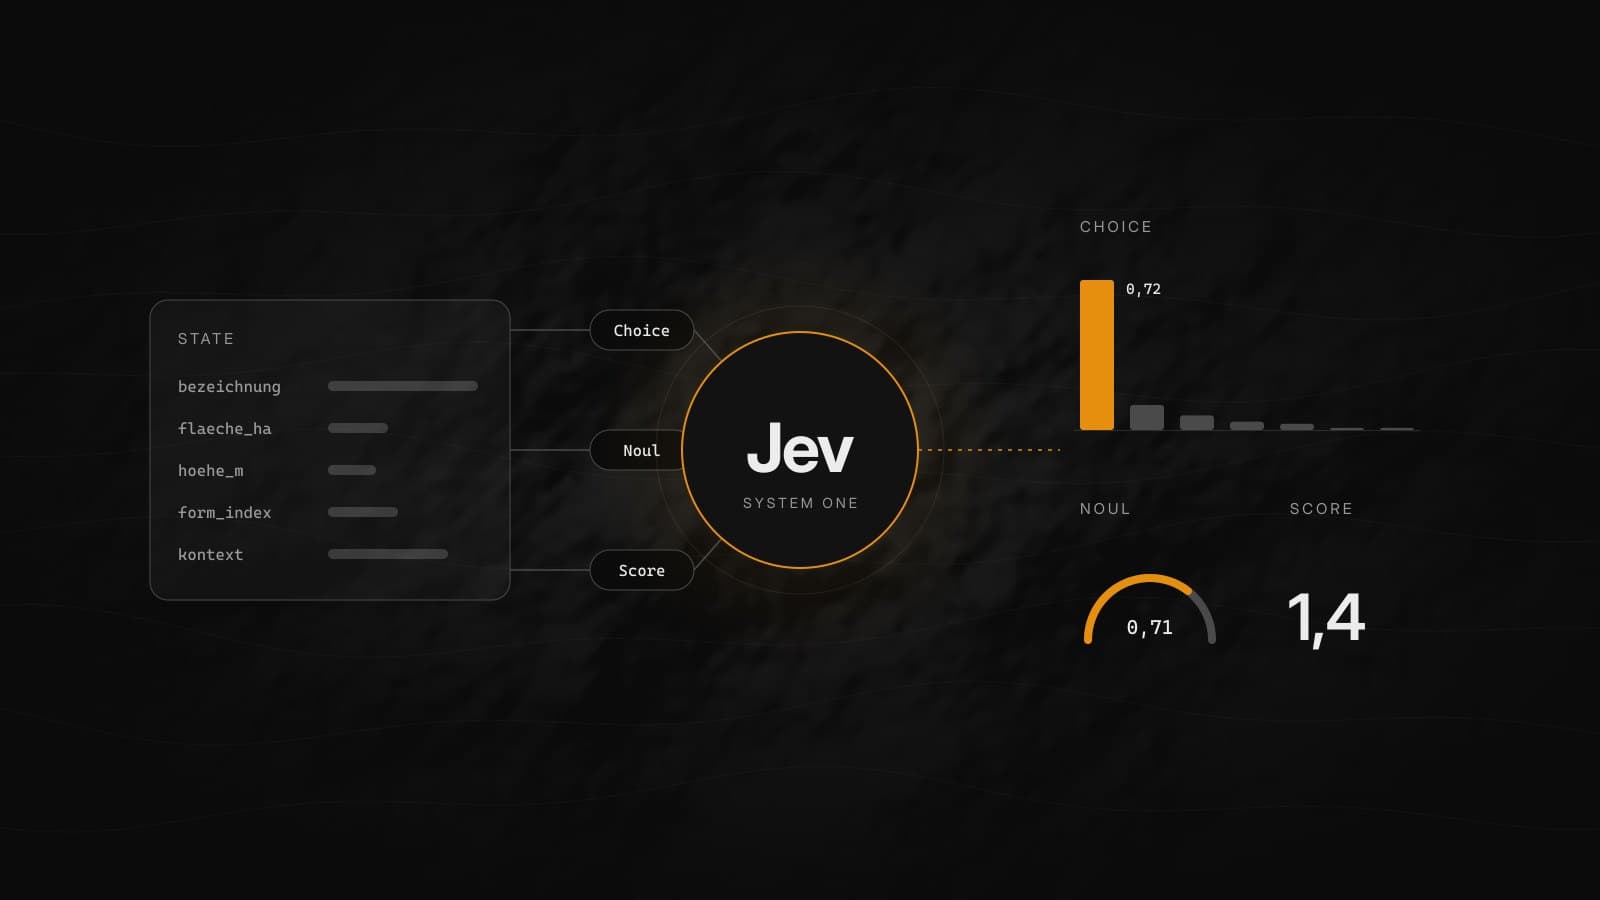
Jev arbeitet anders. Der Aufruf besteht aus zwei Teilen: einem State (die Fakten, als String, Objekt oder Array) und einer Menge benannter Fragen. Das Modell liest den State einmal und beantwortet alle Fragen parallel.
alle Fragen parallel
Jede Frage hat einen von drei Typen:
Choice
Welche Option aus einer festen Menge?
choice, probabilities je Option, confidence
Noul
Trifft eine Bedingung zu?
noul: eine Wahrscheinlichkeit von 0 bis 1
Score
Wo auf einer geordneten Skala?
score, probabilities je Stufe, confidence
Die Antwort ist JSON mit genau diesen Feldern. Es gibt nichts zu parsen, nichts zu bereinigen, keine Erklärung, die das Modell dazuschreibt. Und die Wahrscheinlichkeiten sind kalibriert: TypeSafe trainiert Jev mit einem eigenen Verfahren, das der Hersteller RLCD nennt, Reinforcement Learning for Calibrated Decisions. Das Ziel ist, dass von allen Antworten mit Wahrscheinlichkeit 0,8 etwa 80 Prozent zutreffen. Das gilt über Gruppen von Vorhersagen, nicht für die einzelne Antwort. Eine ehrliche Einschränkung, und genau die Art von Aussage, mit der man arbeiten kann.
Warum Jev für die Archäologie interessant ist
Wer in der Fernerkundung ein Modell urteilen lässt, etwa ob ein Objekt eine gewöhnliche Erklärung hat, stellt drei Anforderungen.
Erstens: Die Antwort muss eine Entscheidung sein, keine Geschichte. „Erklärt als modern“, „erklärt als historisch“ oder „bleibt offen“. Ein Text, der alle drei abwägt, hilft keiner nachfolgenden Sortierung.
Zweitens: Man braucht Wahrscheinlichkeiten, die sich gegen ein Nullmodell und gegen Köder messen lassen. Eine erzählte Konfidenz „ich bin mir zu 85 % sicher“ ist dafür unbrauchbar, weil sie nichts mit der Trefferquote zu tun hat.
Drittens: Das Modell darf nicht wissen, wo es hinschaut. Ein Sprachmodell, dem man Namen und Koordinaten vorenthält, holt sie sich gern aus dem Kontext zurück. Ein Modell, das nur typisierte Fragen über einen kontrollierten State beantwortet, kann nur mit dem arbeiten, was im State steht.
Auf dem Papier erfüllt Jev alle drei Punkte durch seine Bauweise, nicht durch Prompt-Disziplin. Das war der Grund, es zu testen. Ob es die Urteile auch richtig trifft, ist eine andere Frage. Die beantworten die Messungen weiter unten.
Beispiel 1: 20.000 Denkmäler nach Geländeform sortieren
Historic England veröffentlicht die National Heritage List for England, darunter rund 20.000 geschützte Bodendenkmäler mit Bezeichnung und Fläche, frei nutzbar unter Open Government Licence. Für die Fernerkundung interessiert nicht die Epoche eines Denkmals, sondern: Welche Form hinterlässt es im Geländemodell? Nur das verbindet ein Register mit dem, was ein Laserscan messen kann.
Das ist eine klassische Klassifikationsaufgabe mit einem Haken: Die Bezeichnungen sind Freitext („Bowl barrow 300m north of …“, „Vault under Head Post Office“), und es gibt kein Trainingsset. Im ersten Lauf über 400 Einträge sah die Frage so aus:
{
  "model": "jev-latest",
  "state": { "bezeichnung": "Mound S of …", "flaeche_ha": 0.21 },
  "questions": {
    "reliefklasse": {
      "type": "choice",
      "instructions": "Ein geschütztes Bodendenkmal ist durch seine Bezeichnung beschrieben. Welche Form hinterlässt es im Geländemodell?",
      "criteria": {
        "rund_erhaben": "Runde oder ovale Aufwölbung: Grabhügel, Cairn, Motte, Tumulus",
        "linear_erhaben": "Langgestreckter Wall, Damm, Deich oder Erdwerk",
        "linear_vertieft": "Langgestreckter Graben, Hohlweg, Kanal oder Einschnitt",
        "flaeche_umschlossen": "Umschlossene Fläche: Wallburg, Camp, Enclosure, Wassergraben-Anlage",
        "baulich": "Aufgehendes oder verstürztes Bauwerk: Burg, Kloster, Gebäudereste",
        "flaechig_strukturiert": "Flächenhaftes Muster ohne Großform: Feldsystem, Hüttenkreise, Pingenfeld",
        "kein_gelaenderelief": "Hinterlässt keine messbare Geländeform: Brücke, Meilenstein, Wrack, Einzelobjekt"
      }
    },
    "im_dgm_messbar": {
      "type": "noul",
      "instructions": "Würde dieses Denkmal in einem Geländemodell mit 1 m Rasterweite eine messbare Form hinterlassen?",
      "criteria": {
        "true": "Groß und hoch genug, um sich im Höhenbild abzuzeichnen",
        "false": "Zu klein, zu flach oder rein baulich ohne Geländespur"
      }
    },
    "mehrere_objekte": {
      "type": "noul",
      "instructions": "Bezeichnet der Eintrag mehrere Einzelobjekte statt eines einzelnen?"
    }
  }
}Drei Fragen, ein Aufruf. Die Antwort:
{
  "model": "jev-1.13.0",
  "answers": {
    "reliefklasse": {
      "type": "choice",
      "choice": "rund_erhaben",
      "confidence": 1.0,
      "probabilities": { "rund_erhaben": 1.0, "baulich": 0.0, "flaeche_umschlossen": 0.0, "...": 0.0 }
    },
    "im_dgm_messbar": { "type": "noul", "noul": 0.71 },
    "mehrere_objekte": { "type": "noul", "noul": 0.07 }
  },
  "usage": { "input_tokens": 762, "output_tokens": 145 }
}Ein Hügel ist rund und erhaben, wahrscheinlich messbar, ein Einzelobjekt. Das Interessante ist nicht dieser Fall, sondern die Ränder. „Vault under Head Post Office“ bekommt kein_gelaenderelief mit 0,48 gegen baulich mit 0,32, Konfidenz 0,39, Messbarkeit 0,19. Das Modell sagt: unsicher zwischen zwei Klassen, aber ziemlich sicher nicht im Gelände sichtbar. Genau das würde ein Mensch auch sagen.
Und „Two bowl barrows, one 220 m east of …“ bekommt rund_erhaben mit 0,99 und mehrere_objekte mit 0,98.
Für den Volllauf haben wir eine Kein-Treffer-Klasse ergänzt (sonstige_form: passt in keine der anderen Klassen oder ist zu unbestimmt). Alle 20.001 Einträge wurden ohne Fehler beantwortet, gut 14.000 davon gelten dem Modell als „im Geländemodell messbar“. Der gesamte Lauf kostete 67 Cent. So verteilen sich die Klassen:
Die erste Stichprobe über 400 Einträge hatte noch ein ganz anderes Bild gezeigt, mit „baulich“ als größter Klasse. Sie war nach Listennummer gezogen und damit nicht repräsentativ. Auch das ist eine Lehre: Eine Verteilung aus einer bequemen Stichprobe ist keine Verteilung.
Das ist keine Leistungsbehauptung über Archäologie. Ob die Klassen stimmen, haben wir nicht systematisch gegen Fachurteile geprüft. Es ist eine Aussage darüber, was eine typisierte Frage an ein Register kostet und wie sauber sie läuft. Für diese Art Aufgabe, Freitext in feste Klassen, ist Jev nach diesem Test ein gutes Werkzeug.
Beispiel 2: Ortsfreiheit, geprüft statt versprochen
Die Grundlage jeder Arbeit mit archäologischen Daten ist Fundstellenschutz. Ein Modell, das Kandidaten beurteilt, darf niemals Koordinaten, Flurnamen oder Gitterwerte sehen. Das lässt sich behaupten. Für den Test wollten wir es prüfen.
Deshalb lief jeder Aufruf an Jev vorher durch eine automatische Prüfung: Der State wurde gegen Muster für Ortsbezüge und gegen eine Liste erlaubter Felder gehalten. Traf etwas, wurde der Aufruf nicht gesendet. Die Liste erlaubter Felder ist dabei die stärkere Verteidigungslinie, weil sie auch Ortsnamen abfängt, die kein Muster kennt. Der Registerlauf aus Beispiel 1 war eine begründete Ausnahme, weil die Bezeichnungen dort öffentlicher Bestand sind.
Das hat mit Jev im engeren Sinn nichts zu tun. Aber es zeigt, warum ein Modell mit kontrolliertem State so viel einfacher abzusichern ist als ein Chat-Prompt: Der State ist ein JSON-Objekt, das man vollständig prüfen kann, bevor es das Haus verlässt.
Beispiel 3: Urteile über Beschreibungen und warum das nicht trug
Ein Vision-Modell kann Reliefkarten beschreiben und jedem Befund einen Typ und eine „Konfidenz“ geben, als Zahl im Text. Wir wollten wissen, was diese Zahl wert ist.
Dafür haben wir im Test jeden Befund ein zweites Mal klassifizieren lassen, blind: nur die Beschreibung, die Größe und die Lage im Bild, ohne den Typ, den das Vision-Modell vergeben hatte. Jev bekam drei Fragen: Welcher Typ? Ist die Struktur menschgemacht? Und, die wichtigste: Enthält die Beschreibung überhaupt genug konkrete Merkmale, um den Typ zu stützen?
"beschreibung_traegt": {
  "type": "noul",
  "instructions": "Enthält die Beschreibung genug konkrete Merkmale, um den Befundtyp zu stützen?",
  "criteria": {
    "true": "Konkrete Maße, Geometrie oder Lagebezug werden genannt",
    "false": "Die Beschreibung bleibt vage oder interpretierend ohne belegende Merkmale"
  }
}Die Idee dahinter: aus einem Urteil über die Landschaft ein Urteil über die Qualität der Evidenz machen. Ein Befund mit hoher erzählter Konfidenz und niedrigem beschreibung_traegt wäre ein Modell, das sich etwas ausgedacht hat.
Eingelöst hat sich das nicht. Der Grund liegt vor Jev: Wenn schon die Beschreibung falsch ist, etwa bei Größenangaben, kann ein Urteil über die Beschreibung das nicht retten. Jev liest genau das, was dasteht.
Prompt-und-Parse gegen typisierte Urteile
Sprachmodell mit Klassifikations-Prompt
- Antwort ist Text, muss geparst und bereinigt werden
- Konfidenz wird erzählt, nicht gemessen
- Formatabweichungen brechen die Pipeline
- Kontext im Prompt kann Ortsbezüge zurückholen
- Zusatzfragen im selben Prompt können die übrigen Antworten beeinflussen
System-One-Modell (Jev)
- Antwort ist JSON mit festen Feldern
- Wahrscheinlichkeiten sind kalibriert trainiert
- Typ und Optionen sind Teil der Frage, nicht der Hoffnung
- State ist ein prüfbares Objekt
- Fragen sind unabhängig und laufen parallel
Wo Jev im Test gescheitert ist
Die eigentlich spannende Aufgabe ist nicht das Register, sondern die Frage: Ist diese Stelle im Gelände ein Denkmal oder nicht? Dafür haben wir Jev zweimal ernsthaft gemessen, jeweils blind und gegen eine Vergleichsgruppe.
| Versuch | Jev | Vergleich |
|---|---|---|
| 421 bekannte englische Denkmäler gegen Zufallsgelände, State: Formzahlen und Umgebung | AUC 0,59, hält 28 % des Zufallsgeländes für begehenswert | gelerntes Modell aus denselben Zahlen: AUC 0,77 bis 0,82 |
| Filter „alte Geländeform oder modern“, State: Beschreibung in Worten | 100 % „alt“, auch bei allen 12 Stellen, die bei Sichtprüfung modern waren | Bildurteil erkannte 80 bis 86 % der modernen Stellen |
AUC 0,5 ist Münzwurf, 1,0 wäre perfekt. In beiden Fällen steckte die Information in den Daten, das zeigen die Vergleichsmodelle. Jev hat sie nicht nutzbar gemacht. Im ersten Fall aus rohen Zahlen, womit der Hersteller selbst eine Schwäche angibt. Im zweiten fehlte in der Eingabe, was Modernes verrät: rechtwinklig, scharfkantig, aufgereiht. Das sieht man nur im Bild.
Man kann beide Fälle einzeln erklären, und für jeden gibt es eine Idee, was man besser fragen könnte. Aber das Ergebnis bleibt: In der Kandidatenbewertung hat Jev in unseren Tests nicht getragen. Dort sind gelernte Modelle und Bildurteile die bessere Wahl.
Was wir gelernt haben
Die Kein-Treffer-Option ist Pflicht. Ein früherer Test mit einem anderen Modell ist genau daran gescheitert: Moderne Agrarterrassen wurden in eine der vorhandenen Kategorien gepresst, weil keine passte. Jede Choice-Frage sollte eine ausdrückliche Option für „nichts davon“, und wo es sinnvoll ist, eine separate Noul-Frage, ob überhaupt etwas da ist.
Konfidenz ist Verteilungsschärfe, nicht Wahrheit. Die Konfidenz ist eine Kennzahl für die Form der Wahrscheinlichkeitsverteilung. Eine Choice-Konfidenz von 0,4 bedeutet, dass keine Option klar gewinnt. Das kann ein echtes Zwischending sein (ein als „Castle“ geführter Eintrag: 0,50 umschlossene Fläche, 0,42 baulich) oder eine unscharfe Frage. Beides ist nützlich, aber verschieden. Wir schauen uns solche Fälle an, statt sie per Schwellwert zu verwerfen.
Kriterien müssen für sich stehen. Jede Option braucht eine Beschreibung, die ohne die anderen verständlich ist. „Langgestreckter Graben, Hohlweg, Kanal oder Einschnitt“ funktioniert. „Wie oben, aber vertieft“ nicht.
Zahlen sind Kontext, keine Anweisung. Die Fläche in Hektar im State hilft dem Modell, „Vault“ und „Camp“ zu trennen. Aber jede Zahl, die wie eine Koordinate aussieht, muss draußen bleiben, siehe Beispiel 2. Und TypeSafe sagt selbst, dass Jev mit numerischen Darstellungen schlechter umgeht als mit sprachlichen. Beim nächsten Lauf bekommt das Modell statt „0,21 ha“ eine benannte Größenklasse.
Jev liest wörtlich. Der Hersteller führt eine öffentliche Liste der bekannten Schwächen von jev-1.13: Das Modell beantwortet die Frage, die dasteht, nicht die gemeinte; es rechnet und zählt nicht zuverlässig; es verliert bei großem State voller irrelevanter Details; widersprüchliche Kriterien verwirren es. Wie stark das wirkt, haben wir beim Nachprüfen eines veröffentlichten Open-Source-Workflows gesehen. Jev sollte dort entscheiden, ob zwei Einträge denselben Fund meinen. Je nach Wortlaut der Frage ergab dieselbe Auswertung 48, 74 oder 88,8 Prozent. Der Wortlaut einer Frage ist also Teil des Messverfahrens und gehört versioniert.
Die Regel: erst gegen einen Vergleich messen
Die wichtigste Entscheidung im Testaufbau war, Jev nie allein zu messen. Jede Aufgabe lief zugleich über ein Vergleichsverfahren ohne Jev, und jede Antwort wurde mit State, Fragen und Modellversion protokolliert.
Dafür gibt es zwei Gründe. Der erste ist banal: Das Modell ist am 10. September 2026 freigegeben worden, das Unternehmen dahinter ist wenige Wochen alt. Der zweite ist der eigentliche: Nur gegen einen Vergleich zeigt sich, ob ein neues Modell seinen Platz verdient. Genau das hat der Vergleich in der Kandidatenbewertung gezeigt: dort nicht.
Für einen Einsatz mit Behördendaten wären außerdem formale Zusagen nötig: Zero Data Retention, EU-Datenresidenz, Auftragsverarbeitung nach Art. 28 DSGVO. TypeSafe erklärt, Jev werde nicht mit Kundenanfragen trainiert und nicht mit Kundendaten feinjustiert; Zero Data Retention gibt es für Enterprise-Kunden, eine Auftragsverarbeitungsvereinbarung ist dokumentiert.
Für wen sich das lohnt
Die Archäologie ist unser Testfall, aber das Muster ist allgemein. Wo die Bedeutung in Text steckt und Code sie bisher raten musste, mit Regex, Keyword-Listen oder einem Prompt mit anschließendem Parsen, kann ein typisiertes Urteil den Schritt ersetzen: Ticket-Routing, Dokumentklassifikation, Prüfung von Feldern gegen ihre Belege. Wo die Information in Messwerten oder Bildern steckt, ist ein klassisch gelerntes Modell die bessere Wahl. Das war bei uns die teuerste Lektion. Und in beiden Fällen gilt: erst gegen eine Vergleichsgruppe messen, dann einbauen.
Häufige Fragen
Ist Jev ein LLM?
Nicht im üblichen Sinn. Jev baut wie ein LLM auf einem vortrainierten Sprachmodell auf und versteht natürliche Sprache im State. Aber es ist nicht darauf trainiert, Text zu erzeugen, sondern typisierte Fragen mit kalibrierten Wahrscheinlichkeiten zu beantworten. TypeSafe nennt diese Klasse System-One-Modelle, nach Daniel Kahnemans Begriff für das schnelle, intuitive Urteilen.
Kann Jev Bilder auswerten?
Derzeit nicht. Jev nimmt nur Text entgegen. Wir haben beide Umwege getestet: Jev über die Beschreibung eines Vision-Modells und Jev über Geometriezahlen. Beides hat nicht getragen, siehe den Abschnitt über das Scheitern. Für Bilder sind Bildmodelle die bessere Wahl.
Was kostet ein Aufruf?
Abgerechnet werden nur Input-Tokens, 0,042 US-Dollar pro Million, Output-Tokens sind kostenlos (Stand September 2026). Unser Registerlauf lag bei rund 800 Input-Tokens pro Denkmal mit drei Fragen und kostete 67 Cent für alle 20.001 Einträge. Preisstabilität wäre vor einem Behördenprojekt zu klären.
Funktioniert das auf Deutsch?
Englisch ist laut TypeSafe die primäre Trainingssprache, dort ist die Genauigkeit am besten. Andere Sprachen werden verarbeitet, aber nicht gleich gut; der Hersteller rät, auf eigenen Inhalten zu testen und die Konfidenz genau zu beobachten. Unsere Fragen und Kriterien sind deutsch, die NHLE-Bezeichnungen englisch. Der Referenzlauf lief damit ohne Auffälligkeiten, aber ob deutsche Kriterien messbar schlechter abschneiden als englische, haben wir noch nicht geprüft.
Ersetzt das die Fachleute?
Nein. Jev sortiert Register in einer Menge, die ein Mensch nicht durchhält, und gibt zu jeder Sortierung Wahrscheinlichkeiten, die sich prüfen lassen. Bei der Frage, ob eine Stelle im Gelände ein Denkmal ist, hat es im Test nicht geholfen. Was ein Objekt tatsächlich ist, entscheiden ohnehin Archäologinnen und Archäologen. Mehr dazu im Beitrag zum CAA-Vortrag „Context Before Pixels“.