KI · Geodaten
Context Before Pixels: KI-Workflow für LiDAR
Vortrag CAA 2026 Münster: Wie ein Multi-Agenten-Workflow offene LiDAR-Daten in geprüfte Kandidatenlisten für Archäologen verwandelt und sich selbst prüft.
Passende LeistungGeodaten & Fernerkundung
9 Min. LesezeitOnur CirakogluAktualisiert
Inhalt · 12 Abschnitte
Am 17. September 2026 habe ich auf dem CAA Joint Chapter Meeting in Münster einen Vortrag gehalten, der nicht als Archäologie begann. Er begann als Frage an einen Software-Workflow: Was passiert, wenn man ein System, das wir zum Bauen von Webprojekten nutzen, auf die offenen Höhendaten eines Testgebiets richtet? Die ehrliche Antwort: Es fand schnell etwas. Manches davon war falsch. Und das Interessante seit Februar ist, wie der Workflow gelernt hat, seine eigenen Fehler zu fangen.
Dieser Artikel ist die Langfassung des Vortrags „Context Before Pixels: A Data-Driven Human-in-the-Loop LLM Workflow for LiDAR-Based Archaeological Prospection“. Er zeigt einen Workflow, keine Entdeckung.
Woher das kommt: ein Workflow, der Software baut
Der Ursprung gehört an den Anfang, weil er das Projekt erklärt. Die Pipeline wurde nicht für Archäologie gebaut. Sie ist der Multi-Agenten-Workflow, mit dem wir bei headon Software entwickeln: Ein Modell plant. Es übergibt die Arbeit an spezialisierte Agenten, die parallel laufen. Einer implementiert, einer testet, einer prüft, einer dokumentiert. Und jede Rolle, jede Regel liegt in versionierten Textdateien, sodass sich jeder Lauf wiederholen und nachträglich kontrollieren lässt.
Anfang 2026 habe ich eine einfache Frage gestellt: Was passiert, wenn man dieses System auf die frei verfügbaren Laserscan-Daten des Landes richtet? Deutsche Landesvermessungen stellen hochauflösende Digitale Geländemodelle offen zur Verfügung. Darin sind Bodenstrukturen sichtbar, die man im Gelände nicht mehr sieht, weil Wald, Ackerbau und Jahrhunderte darüber liegen.
Context before pixels, präzisiert
Im Mai hatte ich den Titel „Context before pixels“ eingereicht. Gemeint war: Erst die historischen Karten, die Denkmalregister, die Flurnamen sammeln, dann analysieren. Das gilt weiterhin. Was ich seither gelernt habe, ist, wann der Kontext wirken darf.
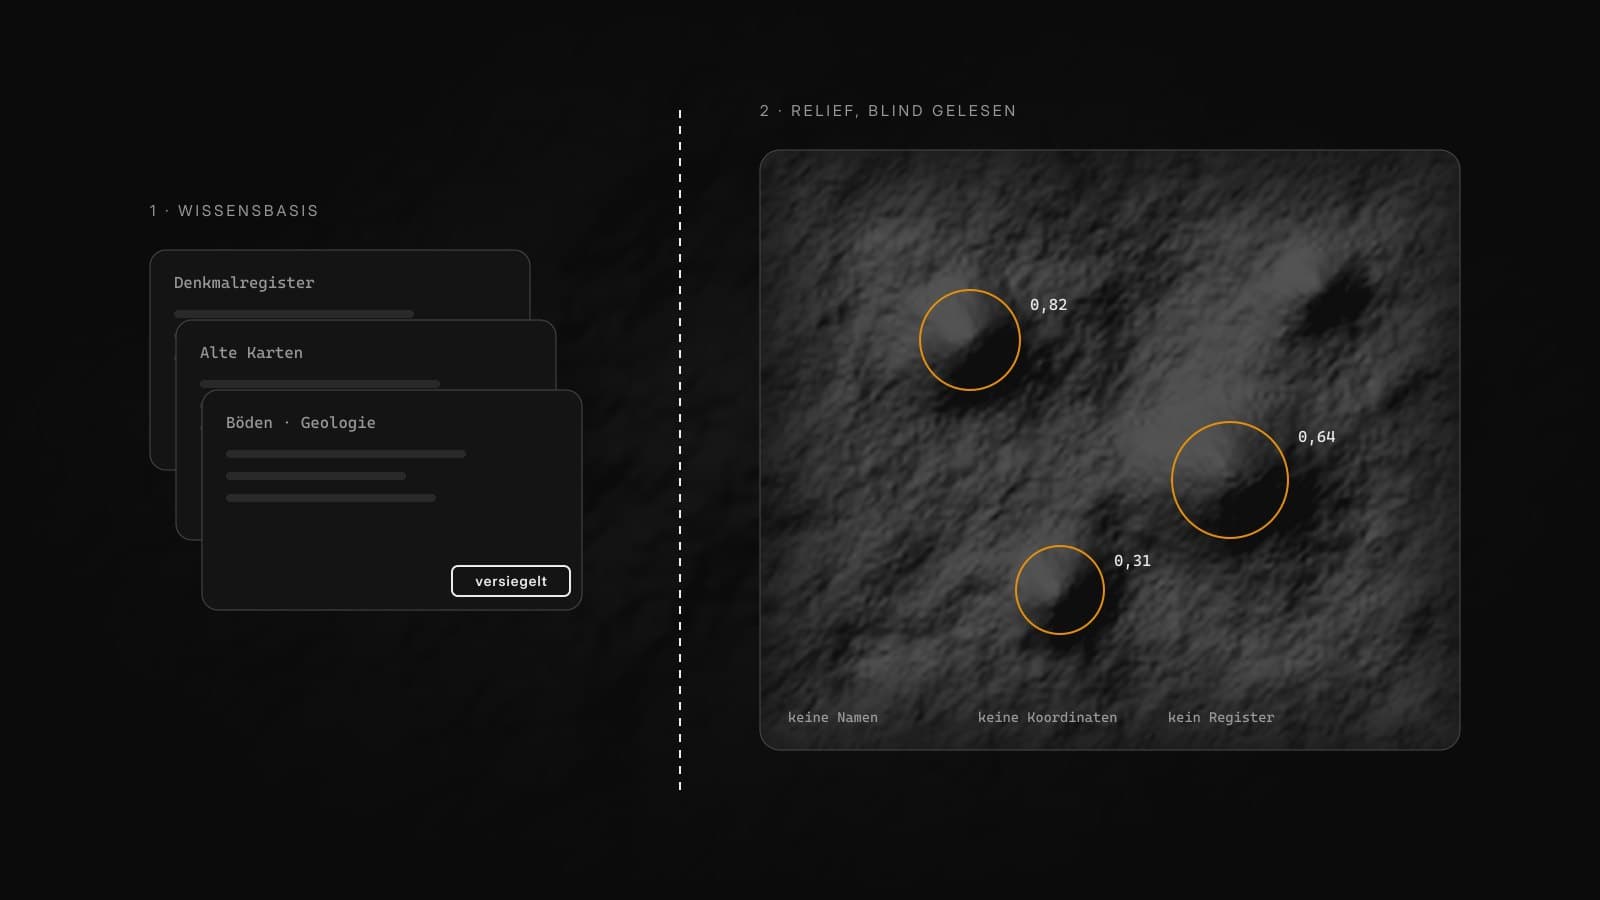
Die Wissensbasis muss vor der Analyse existieren. Wer erst nach dem Sehen nach Quellen sucht, findet die Quellen, die zum gesehenen Bild passen. Also wird sie zuerst gebaut und versiegelt. Aber sie darf den ersten Blick nicht berühren. Wer den Kontext im Kopf hat, sieht, was er erwartet. Deshalb wird das Relief blind gelesen: ohne Namen, ohne Koordinaten, ohne Register. Das Wissen kommt in einem zweiten, getrennten Durchgang dazu, und jede Änderung, die es an der blinden Liste vornimmt, wird als solche markiert.
Unsere eigene Arbeitsregel sagt es in einem Satz: „Erst das Relief allein, dann das Wissen. Wer umgekehrt vorgeht, findet, was er erwartet.“ Das ist das Thema des ganzen Vortrags: Sehen, was man erwartet, und wie man das durch die Bauweise des Systems schwer macht.
Die Achse: Erwartung minus Beobachtung
Alles Weitere folgt aus einem Gedanken. Die Wissensseite sagt, was in dieser Landschaft zu erwarten wäre: was die Register kennen, was die alten Karten zeigen, was Boden und Landnutzung zulassen. Die Reliefseite sagt, was heute noch messbar ist. Das Produkt ist die Differenz, und nur die Differenz: eine priorisierte Liste von Kandidaten zur fachlichen Prüfung.
Jeder Kandidat trägt eines von drei Labels: erklärt als modern, erklärt als historisch, oder bleibt offen. Nur die letzte Gruppe ist interessant, und sie ist absichtlich klein. Sie im Gelände zu prüfen ist genehmigungspflichtige Arbeit. Sie gehört den Landesämtern und Partnern. Die Liste wird für sie geschrieben.
Die Wissensseite: Das Register ist eine Erwartung, keine Wahrheit
Was die Wissensseite zusammenführt: amtliche Denkmalregister, Luftbilder zurück bis in die 1950er Jahre, historische Katasterkarten, Geologie und Böden, Landnutzung und Wegenetze, Flurnamen, Grabungs- und Literaturnachweise. All das ist offen lizenziert und kostenlos. In dieser Kombination führt es kaum jemand automatisiert und flächig zusammen.
Die überraschende Entdeckung dabei: Das Register selbst ist ein Messobjekt. Die Umrisse sind verlässlich. Was das Register über ein Objekt sagt, ist es nicht: Viele Einträge sind unbestimmt, Datierungen sind Spannen statt Werte, Typ und Epoche stehen oft nur im Freitext.
Ein Gebiet, ein Durchlauf
So sieht ein Lauf im Prinzip aus. Aus den Rohdaten entstehen mehrere Reliefvisualisierungen desselben Gebiets, jede betont andere Formen: Senken, Kanten, flache Erhebungen, lange Linien.
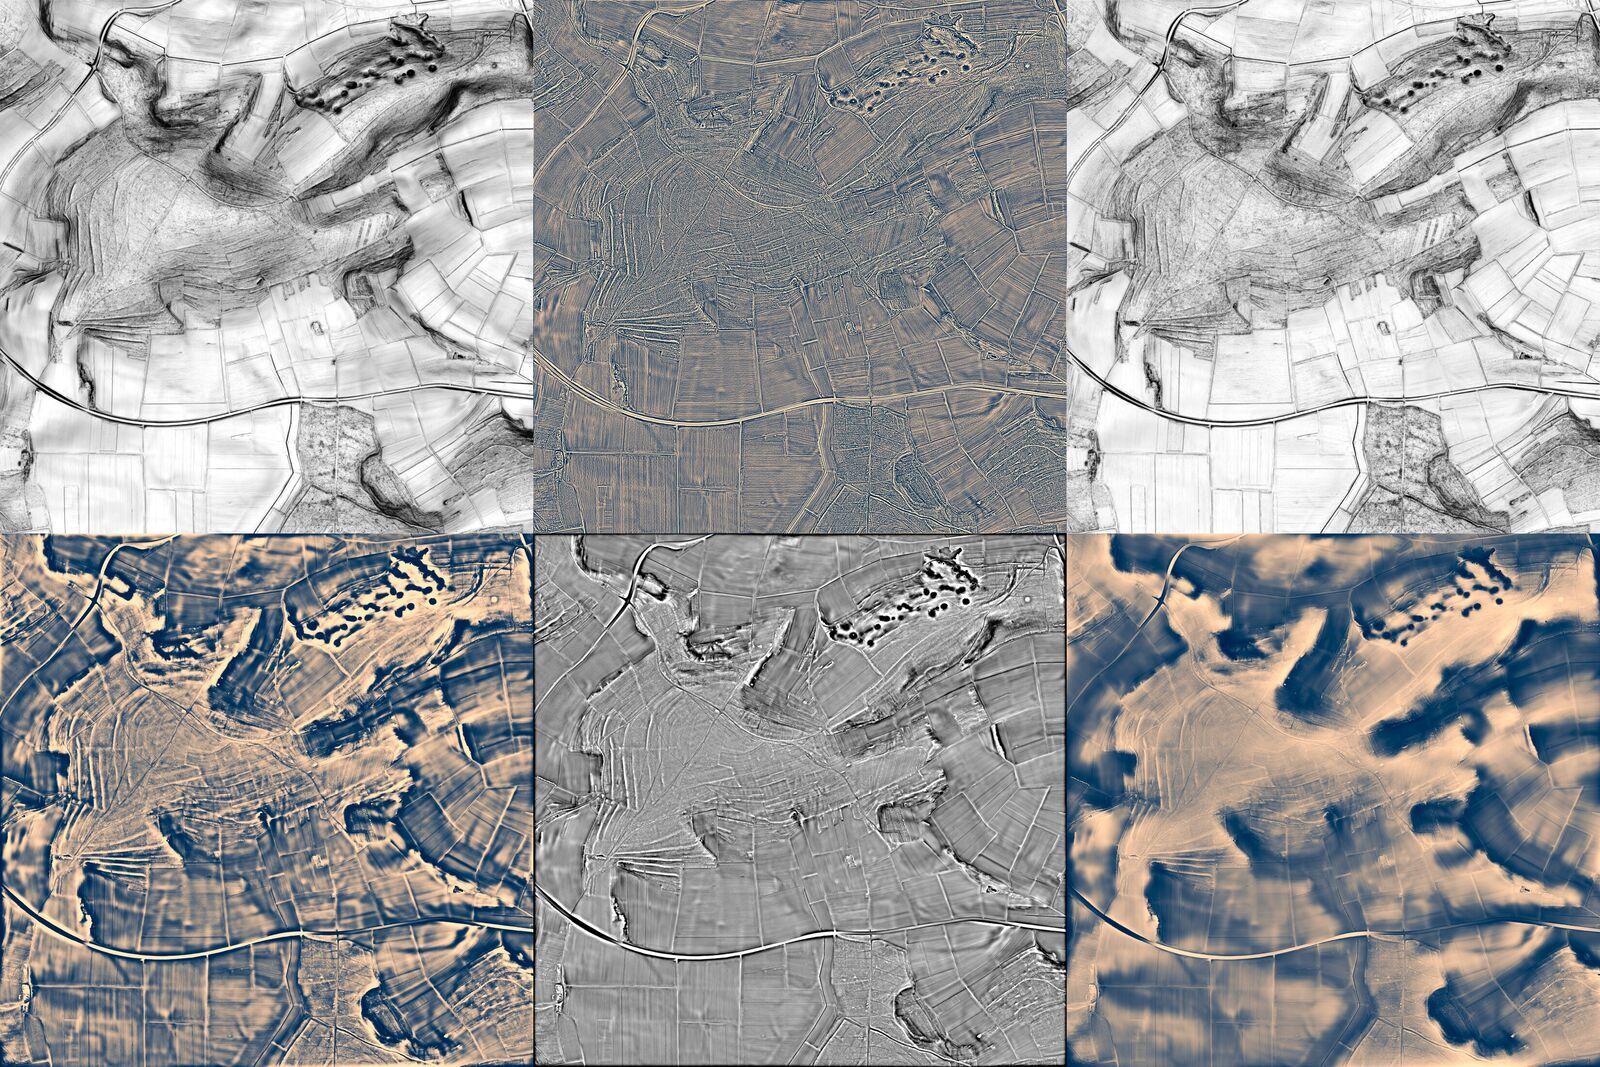
Dann listet die Maschine jede kompakte Form, jede Linie, jede Einfriedung. Nichts wird je gelöscht, nur beschriftet. Danach kommt das Sieb: Die große Mehrheit wird erklärt, und jede Verwerfung trägt ihren Grund. Ein Straßeneinschnitt, ein Teich aus den Neunzigern, eine Forstparzelle, Windwurf, eine Terrasse. Ein paar bleiben übrig.
Dasselbe läuft parallel auf dem nächsten Gebiet. Und um ehrlich zu bleiben, lassen wir die Kette blind über Gebiete laufen, die bekannte, registrierte Denkmäler enthalten. Sie hat in Blindläufen registrierte Denkmäler verschiedener Typen wiedergefunden. Wo sie sich schwertut, ist genau da, wo man es erwartet: bei eingeebneten Grabhügeln in altem Wald.
Wer sieht was, wer entscheidet was
Ein Gutachter des Programmkomitees hat zu Recht gefragt, welcher Teil einer Interpretation von der KI kommt und welcher vom Menschen. Hier ist die Antwort als Bild.
- 1 · Relief & InventarMaschine: Filter, Formen, Linien, NullmodellMensch: wählt das Gebiet
- 2 · BlindpaketMaschine: mischt, entfernt Namen und Koordinaten, siegeltMensch: gibt das Paket frei
- 3 · Erster BlickMaschine: baut eine Akte pro ObjektSprachmodell: blinder Gutachter, ein Objekt nach dem anderen, nennt die beste Alltagserklärung
- 4 · Protokoll & AuditMaschine: Vollständigkeit, Prüfsummen, ProtokollSprachmodell: kein Urteil
- 5 · Zweiter DurchgangMaschine: führt die Wissensquellen zusammenSprachmodell: separater Agent, jede Änderung wird markiert
- 6 · ErgebnisMaschine: priorisierte KandidatenlisteMensch: liest, entscheidet, übergibt
Die Maschine macht alles, was nach festen Regeln läuft, ohne Modell: die Reliefkarten, das Inventar, das Nullmodell. Sie baut das Blindpaket, mischt die Kacheln, entfernt Namen und Koordinaten und versiegelt den Lösungsschlüssel. Sie legt eine Akte pro Objekt an, prüft das Protokoll, führt die Wissensquellen zusammen und schreibt die Liste.
Das Sprachmodell urteilt an genau zwei Stellen. Als blinder Gutachter, ein Objekt nach dem anderen, verpflichtet, für jedes die beste gewöhnliche Erklärung zu nennen. Und als separater Agent im zweiten Durchgang, wo jede Änderung markiert wird. Im Audit-Schritt darf es ausdrücklich nicht urteilen.
Der Mensch wählt das Gebiet, gibt das Paket frei und liest am Ende das Ergebnis und übergibt es.
Warum man dem trauen darf: vier Prinzipien
Warum sollte irgendjemand eine KI das überhaupt tun lassen? Vier Prinzipien, und keine Zahlen.
Blind lesen.
Das Modell weiß nicht, wo es hinschaut und was dort bekannt ist.
Köder setzen.
Künstliche Formen, mit einem Erosionsmodell gealtert, in echtes Gelände gemischt. Bewertet wird das Verwerfen, nicht das Finden.
Buchführung mit Prüfer.
Jede Entscheidung wird protokolliert und von einem unabhängigen Agenten geprüft, bevor jemand den Lösungsschlüssel sieht.
Nullmodell mitführen.
Jede Anomalie wird gegen das gehalten, was leeres Gelände ohnehin produziert. Sonst misst man den Filter, nicht die Landschaft.
„KI findet mehr“ ist nicht die interessante Behauptung. Der Beitrag ist eine KI, die sich beim Irren erwischen lässt: bei jedem Lauf, nicht erst, wenn zufällig jemand daran denkt.
Die Köder-Geschichte
Eine Geschichte zeigt, was das bedeutet. In einem unserer Ködertests tat die Kette genau, was sie sollte: Keine der Fälschungen wurde für echt erklärt. Und trotzdem stand am Ende ein Köder ganz oben auf der Prioritätenliste. Ein Segment eines Kreisgrabens, das nicht existiert.
Nicht, weil es überzeugend war. Die Konfidenz war niedrig. Sondern weil es in seinem Kontext das sauberste Objekt gewesen wäre, das man prüfen könnte. Und weil der Wissensdurchgang publizierte Parallelen dafür gefunden hatte.
Was herauskommt, und was fehlt
Was tatsächlich herauskommt: für jedes Gebiet eine kurze Liste, die den Blick einer Fachperson wert ist, und für jeden verworfenen Kandidaten der Grund. Dieses Aussortieren ist der Hebel. Nicht das Finden, sondern das begründete Aussieben in einem Umfang, den ein Mensch nicht durchhält.
Und was fehlt, klar gesagt:
Was der Workflow heute leistet und was nicht
Kommt heraus
- Eine kurze, priorisierte Liste pro Gebiet
- Für jeden verworfenen Kandidaten ein schriftlicher Grund
- Jede Entscheidung protokolliert und unabhängig geprüft
- Blindläufe finden registrierte Denkmäler wieder
- Nachvollziehbar, wiederholbar, auf offenen Daten
Fehlt noch
- Präzision: Zu viele Kandidaten überleben das Sieb
- Recall: Wir wissen nicht, welchen Anteil des Vorhandenen wir finden
- Alter: Jahrhunderte Erosion sind flach, scharfe Formen sind meist jung
- Validierung: Kein Kandidat wurde bisher von Befugten bestätigt
Der Satz „Wo wir nichts finden, ist nichts“ ist deshalb keiner, den wir sagen können. Und weil jeder Kandidat bisher am Schreibtisch begründet ist, ist das Ergebnis eine Liste zur Fachprüfung, keine Landschaftsinterpretation. Wir bauen keine These. Wir bauen eine Liste für Menschen, die prüfen können.
Wohin das geht: eigene Modelle
Beide Seiten der Differenz sind noch zu unscharf. Die Reliefseite liefert zu viele Kandidaten, die Wissensseite liegt im Freitext. Also: eigene Modelle. Und ich sage deutlich, das ist Richtung, nicht Ergebnis.
- Ein sehendes Modell, trainiert auf echten Signaturen: Referenzbeispiele registrierter Denkmäler, die noch ein Signal tragen, verschlagwortet nach Typ, Epoche, Bodenbedeckung und Erhaltung.
- Ein urteilendes Modell, nicht zum Sehen, sondern zum Entscheiden: Welche Parallele passt, welche Erklärung ist zuerst auszuschließen. Seine Trainingsdaten entstehen von selbst, weil jede Verwerfung bereits mit Begründung protokolliert ist.
- Das Nicht-Signal ist auch ein Datum. Wo das Register eine Struktur verzeichnet, die einmal Relief hatte, und nichts mehr da ist, ist das ein Datenpunkt zur Sichtbarkeit. Genug davon, und man könnte schätzen, was nach Epoche und Bodenbedeckung heute noch sichtbar ist. Eine Forschungsrichtung, kein Ergebnis.
Wissen und Rohdaten, Differenz, Fachprüfung, neues Wissen, besseres Modell, schärfere Differenz. Jede Umdrehung schärft beide Seiten.
Was das Projekt jetzt braucht
Das Projekt läuft seit sieben Monaten auf offenen Daten. Für den nächsten Schritt braucht es vier Dinge, in der Reihenfolge ihrer Wahrscheinlichkeit:
- Archäologinnen und Archäologen, die mitbeurteilen. Zu entscheiden, was diese Dinge sind, ist nicht meine Aufgabe und soll es nicht sein.
- Referenzdaten und Flächen, auf denen Schreibtischargumente von denen geprüft werden können, die dazu befugt sind.
- Eine Institution als Partner in einem Antrag: eine Universität oder ein Landesamt.
- Direkte Unterstützung, für wen das möglich ist: Rechenzeit, Daten, Arbeitszeit.
Der erste gemeinsame Schritt ist klein: ein Gebiet, gewählt von einem Partner mit Referenzdaten. Die Kette läuft blind, der Partner hält den Schlüssel, wir vergleichen. Zwei Wochen Arbeit, kein Feldzugang nötig.
Häufige Fragen aus der Diskussion
Ist das ein RAG-System?
Nein, kein Vektorindex. Die Wissensquellen werden erst im zweiten Durchgang und über einen getrennten Agenten zugeschaltet, und jede wissensgetriebene Änderung wird markiert.
Welche Modelle kommen zum Einsatz?
Allgemeine KI-Modelle in festen, getrennten Rollen. Entscheidend ist weniger das Modell als der Aufbau: Das Blindpaket entfernt Namen und Koordinaten, bevor ein Modell eine Kachel sieht, und die Zerlegung der Aufgabe schlägt den einen großen Blick.
Waren Sie im Gelände?
Verifikation im Gelände ist genehmigungspflichtige Arbeit, und sie hat für keinen einzigen Kandidaten stattgefunden. Die Liste ist für die Menschen geschrieben, die diese Genehmigung haben.
Gibt es Zahlen?
Es gibt interne Tests, die den Bau geleitet haben: Blindtests gegen das amtliche Register, Köderläufe, Nullmodell-Audits. Sie sind nicht extern validiert und nicht wiederholt, deshalb stehen sie weder auf den Folien noch in diesem Artikel. Was sie gemeinsam haben: Sie messen Grenzen, nicht Leistung. Genau das hat das Design geprägt.
Was hat das mit Webentwicklung zu tun?
Alles, was diesen Workflow trägt, kommt aus unserer täglichen Arbeit: spezialisierte Agenten in festen Rollen, versionierte Anweisungen, unabhängige Prüfschritte, wiederholbare Läufe. Die Archäologie war der Test, ob diese Bauweise auch dort hält, wo ein Fehler nicht ein Bug ist, sondern eine falsche Meldung an ein Landesamt. Sie hält, wenn man sie so baut, dass sie sich beim Irren erwischen lässt.